MEINE KI-UMGEBUNG
Seit einiger Zeit beschäftige ich mich intensiver mit lokaler KI und insbesondere mit dem Betrieb von KI-Modellen auf eigener Hardware. Mich interessiert dabei nicht nur, was die Modelle können, sondern auch, wie sie aufgebaut, betrieben und in eigene Anwendungen eingebunden werden können.
Dafür habe ich eine eigene KI-Umgebung eingerichtet, in der verschiedene Modelle und Werkzeuge lokal laufen. So kann ich unterschiedliche Konfigurationen ausprobieren, Modelle miteinander vergleichen und die Systeme an meine eigenen Anforderungen anpassen.
Ein wichtiger Punkt ist für mich, dass die Modelle möglichst lokal und unabhängig von externen Cloud-Diensten betrieben werden. Dadurch behalte ich die Kontrolle über die eingesetzte Hardware, die Konfiguration und die Verarbeitung der Daten.
HARDWARE & GPU-INFRASTRUKTUR
Mein KI-Server
Dell Precision T7610
2 × NVIDIA RTX 3060
Je 12 GB Grafikspeicher
Intel Xeon E5-2687W v2
Modellbetrieb
Lokale GPU-beschleunigte Inferenz
Quantisierte Modelle
GPU-Speicherverwaltung
Containerisierte KI-Dienste
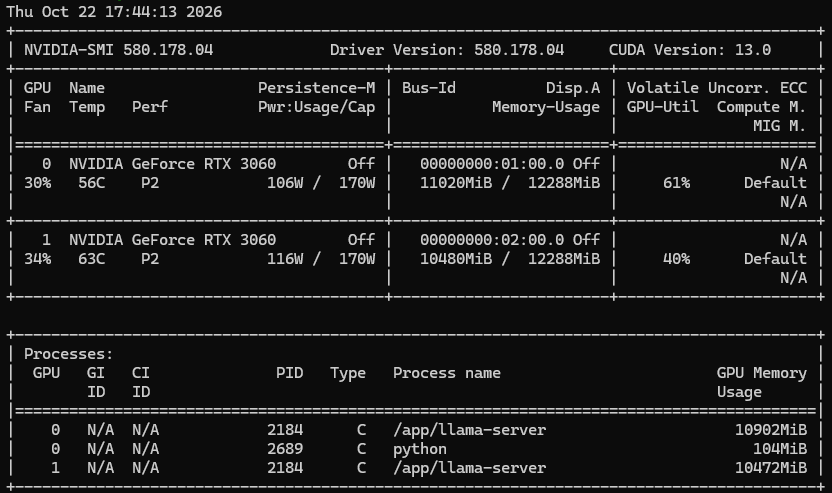
Als Grundlage verwende ich eine Dell Precision T7610 mit zwei NVIDIA RTX 3060, die jeweils über 12 GB Grafikspeicher verfügen.
Da der verfügbare GPU-Speicher begrenzt ist, beschäftige ich mich auch mit Modellgrößen, Quantisierung und der Verteilung der Berechnungen auf die Grafikkarten. Dabei probiere ich unterschiedliche Einstellungen aus, um größere Modelle möglichst sinnvoll auf meiner vorhandenen Hardware betreiben zu können.
Die dazugehörigen KI-Dienste laufen in einer eigenen Linux-Umgebung. Dadurch kann ich Modelle und Anwendungen getrennt verwalten und bei Bedarf unterschiedliche Konfigurationen testen.
MODELLE & SOFTWARE
Qwen & Sprachmodelle
Als Sprachmodelle verwende ich unter anderem Qwen in verschiedenen Varianten. Die Modelle laufen lokal und werden für unterschiedliche Aufgaben getestet, beispielsweise zur Textverarbeitung, Unterstützung bei der Programmierung und für technische Fragestellungen.
Schwerpunkte: Qwen · lokale LLMs · GGUF · Quantisierung
llama.cpp
Für die Ausführung meiner Sprachmodelle nutze ich llama.cpp mit GPU-Beschleunigung. Dabei beschäftige ich mich mit der Verteilung der Modelle auf beide Grafikkarten, der Kontextgröße und den verfügbaren Ressourcen.
Schwerpunkte: llama.cpp · CUDA · GPU-Offloading · Modellkonfiguration
Open WebUI
Mit Open WebUI habe ich eine eigene Weboberfläche für meine lokalen Sprachmodelle eingerichtet. Darüber kann ich die Modelle verwenden und unterschiedliche Einstellungen und Anwendungsfälle ausprobieren, ohne auf einen externen KI-Dienst angewiesen zu sein.
Schwerpunkte: Open WebUI · Chatoberfläche · Modellanbindung · APIs
Weitere KI-Werkzeuge
Neben Sprachmodellen beschäftige ich mich auch mit weiteren KI-Anwendungen. Dazu gehören ComfyUI für bildbasierte Workflows, SearXNG für die Suche und n8n zur Automatisierung unterschiedlicher Abläufe.
Mich interessiert besonders, wie sich diese Werkzeuge miteinander verbinden lassen.
Schwerpunkte: ComfyUI · SearXNG · n8n · Workflow-Integration
AUFBAU & INTEGRATION
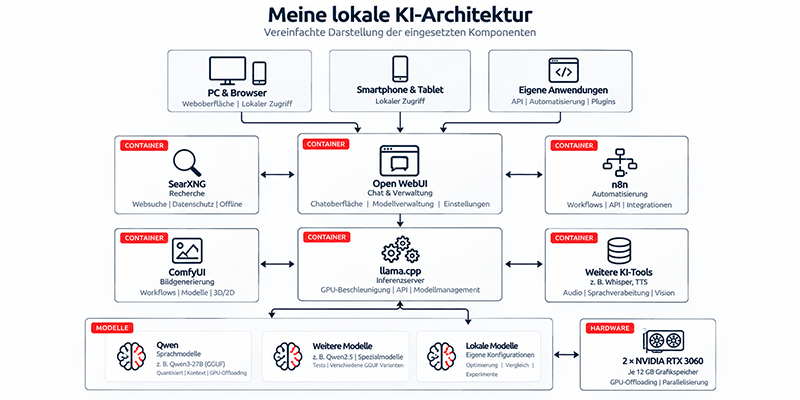
Meine KI-Umgebung besteht aus mehreren Komponenten, die jeweils unterschiedliche Aufgaben übernehmen. Während llama.cpp die Sprachmodelle ausführt, dient Open WebUI als Oberfläche für die direkte Nutzung.
Die Modelle werden über Schnittstellen bereitgestellt und können dadurch auch unabhängig von der Chatoberfläche angesprochen werden. Das ist für mich besonders interessant, weil sich KI-Funktionen so in eigene Programme und automatisierte Abläufe integrieren lassen.
Die einzelnen Dienste betreibe ich möglichst getrennt voneinander, damit ich Modelle austauschen oder Konfigurationen verändern kann, ohne die gesamte Umgebung neu aufbauen zu müssen.
AUS DER PRAXIS
Eine der Herausforderungen bei meiner lokalen KI-Umgebung ist der begrenzte Grafikspeicher. Gerade größere Sprachmodelle benötigen viel Speicher, sodass die Konfiguration der Modelle und die Verteilung auf die vorhandenen GPUs eine wichtige Rolle spielen.
Aktuell nutze ich unter anderem ein quantisiertes Qwen-Modell mit rund 27 Milliarden Parametern. Für die Ausführung verwende ich llama.cpp und verteile die benötigten Ressourcen auf meine beiden RTX 3060.
Dabei beschäftige ich mich mit unterschiedlichen Einstellungen wie Kontextgröße, Quantisierung, GPU-Offloading und parallelen Anfragen. Ziel ist es, die vorhandene Hardware möglichst sinnvoll zu nutzen und die Modelle stabil betreiben zu können.
Eingesetzte Technologien: Qwen · llama.cpp · GGUF · CUDA · NVIDIA RTX 3060 · Linux · Docker

AKTUELLE EXPERIMENTE
Neben dem Betrieb meiner lokalen KI-Modelle beschäftige ich mich auch mit neuen Anwendungsmöglichkeiten. Besonders interessieren mich dabei die Sprachsteuerung, die Integration von KI in eigene Anwendungen und die Erstellung von 3D-Modellen. Einige dieser Ideen befinden sich noch in der Entwicklung, andere probiere ich bereits praktisch aus.
Lokale Sprachsteuerung
Aktuell beschäftige ich mich mit einer lokalen Sprachsteuerung für meine Hausautomatisierung. Dazu gehören Spracherkennung, Sprachausgabe und die Anbindung an openHAB und Home Assistant.
Ziel ist eine Lösung, die ohne externe Cloud-Dienste auskommt und über unterschiedliche Geräte genutzt werden kann.
Schwerpunkte: STT · TTS · openHAB · Home Assistant
KI-Integration in eigene Anwendungen
Neben der Nutzung über Open WebUI möchte ich meine lokalen KI-Modelle stärker in eigene Anwendungen integrieren. Dafür beschäftige ich mich mit APIs und automatisierten Abläufen.
Besonders interessant finde ich die Verbindung von KI mit vorhandenen Systemen, um wiederkehrende Aufgaben zu unterstützen oder zu automatisieren.
Schwerpunkte: REST APIs · C#/.NET · n8n · Automatisierung
KI-gestützte 3D-Erstellung
Ein weiteres Thema ist die Erstellung von 3D-Modellen mithilfe künstlicher Intelligenz. Besonders interessiert mich, wie sich aus mehreren Bildern ein verwendbares 3D-Modell erzeugen lässt.
Langfristig möchte ich solche Modelle für eigene Gestaltungsprojekte und den 3D-Druck einsetzen und verschiedene Verfahren miteinander vergleichen.
Schwerpunkte: Bild-zu-3D · 3D-Modelle · 3D-Druck · Modellgenerierung
WEITERE EINBLICKE
Meine lokale KI-Umgebung ist Teil meiner eigenen Serverinfrastruktur und wird laufend erweitert. Neben dem Betrieb der Modelle beschäftige ich mich dabei auch mit der Softwareentwicklung, den benötigten Schnittstellen und der Automatisierung.
Weitere Informationen zur zugrunde liegenden Infrastruktur und zu meinen anderen Entwicklungsprojekten gibt es auf den entsprechenden Seiten.